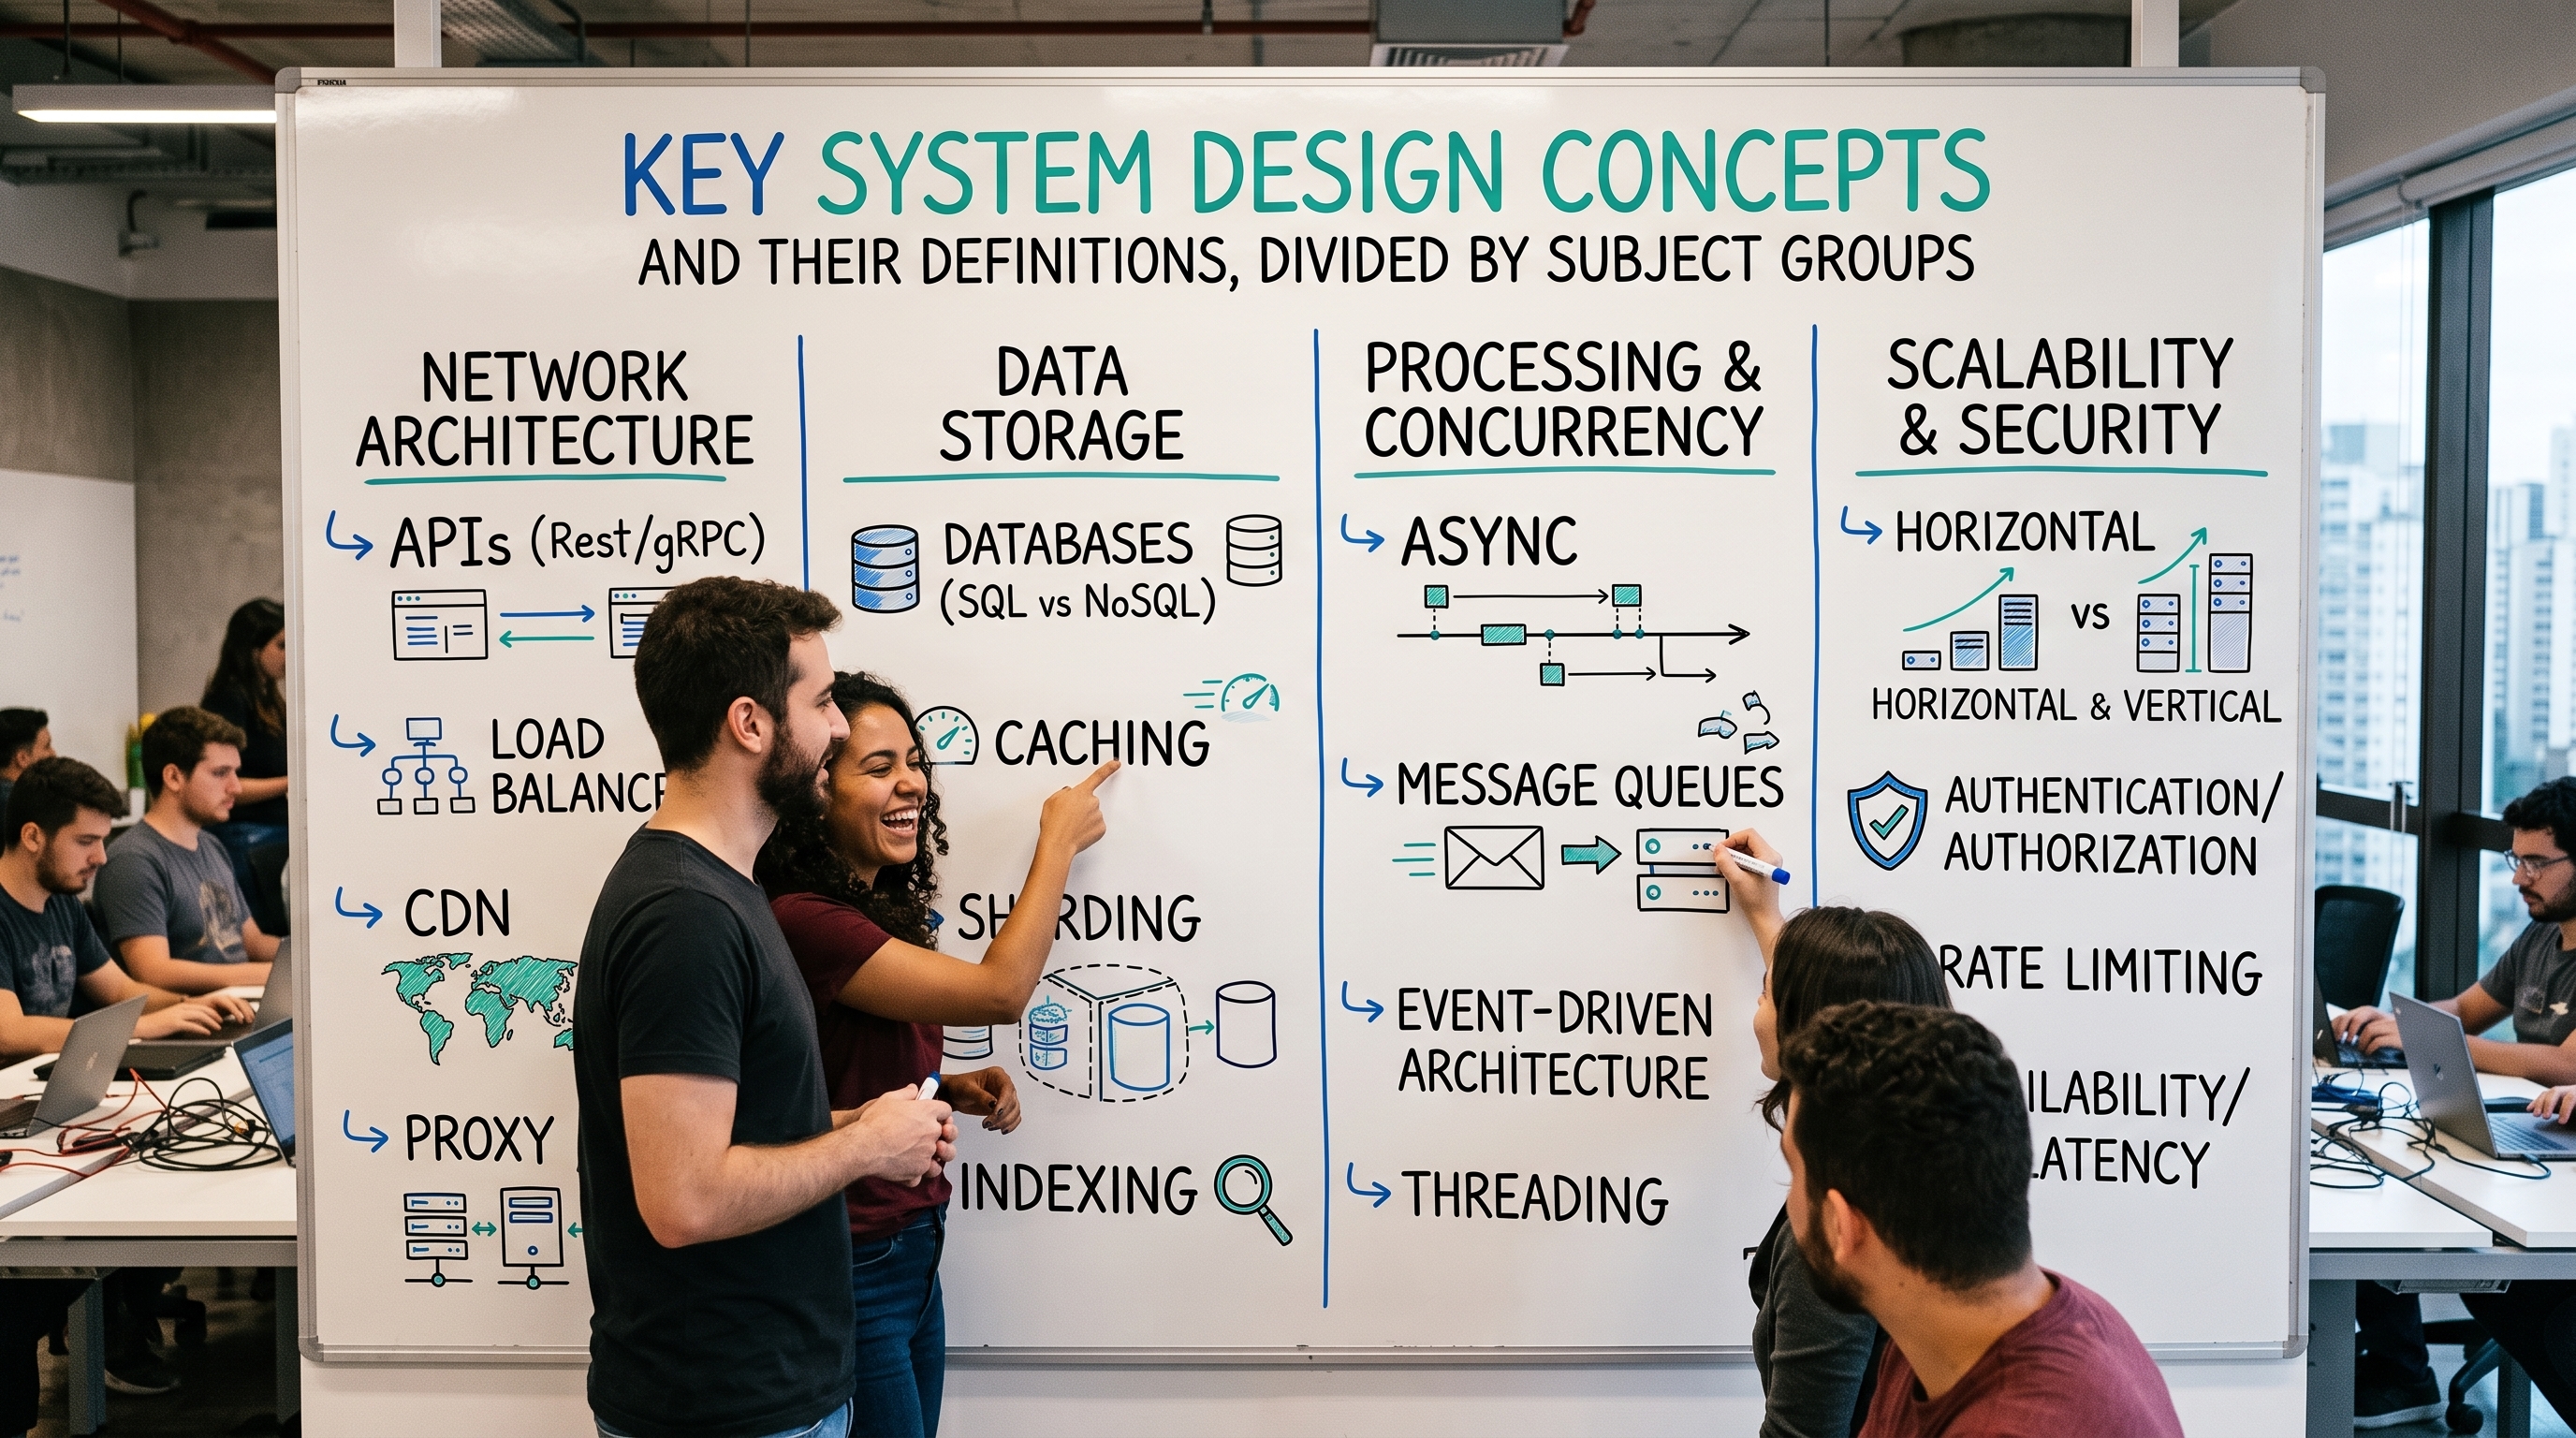
Conceitos-chave de System Design e suas definições. Key system design concepts and their definitions.
Uma lista prática dos principais conceitos de System Design que você precisa dominar. A practical list of the key system design concepts you need to master.
1. Escalabilidade & Arquitetura de Servidores
Escalabilidade Vertical (Scale-Up): Consiste em aumentar a capacidade do sistema adicionando mais recursos (como CPU, memória RAM ou armazenamento em disco) a um único servidor. Possui limites físicos, tecnológicos e de custo, além de criar um ponto único de falha.
Escalabilidade Horizontal (Scale-Out): Consiste em responder ao aumento de demanda adicionando mais servidores (clones) em paralelo a um agrupamento ou pool de recursos.
Arquitetura Stateless (Sem Estado): Padrão arquitetural em que os servidores web não armazenam dados de sessão ou arquivos do usuário em seus discos ou memórias locais. Isso permite que qualquer requisição possa ser atendida por qualquer servidor do cluster de forma idêntica.
Clones e Imagens de Máquina: Servidores web idênticos criados a partir de um modelo ou imagem mestre (como uma AMI). Permitem inicializar novas instâncias rapidamente e implantar código atualizado de forma uniforme.
2. Gerenciamento de Tráfego & Rede
Load Balancer (Balanceador de Carga): Dispositivo de hardware ou software posicionado entre os clientes e a frota de servidores para distribuir as requisições de tráfego de maneira uniforme.
Algoritmos de Roteamento (Round-Robin vs. Baseado em Carga): Métodos que o balanceador utiliza para distribuir tráfego. O Round-Robin envia as requisições em fila sequencial simples, enquanto abordagens dinâmicas checam periodicamente a carga ou processamento atual de cada servidor.
Sticky Sessions (Sessões Pegajosas): Mecanismo no qual o balanceador armazena uma referência (geralmente via cookie) para garantir que requisições subsequentes de um mesmo usuário sejam enviadas ao mesmo servidor onde sua sessão local foi iniciada.
Alta Disponibilidade (High Availability / Failover): Capacidade de manter o serviço ativo mesmo diante de falhas de hardware, utilizando nós redundantes que operam em pares ativo-passivo com sinais de heartbeat para assumir o tráfego se a máquina principal cair.
3. Desempenho, Armazenamento & Caching
In-Memory Caching (Cache em Memória): Camada de buffer de altíssima velocidade (como Memcached ou Redis) que armazena dados frequentemente acessados diretamente na memória RAM para evitar consultas custosas ao disco físico do banco de dados.
Latência: O tempo total decorrido para concluir uma única tarefa ou produzir um resultado individual.
Throughput (Vazão): A quantidade total de tarefas, registros ou requisições que o sistema consegue processar e concluir por unidade de tempo.
Políticas de Evicção de Cache (ex: LRU): Regras de descarte executadas quando a memória RAM do cache atinge o limite. O algoritmo Least Recently Used (LRU) remove primeiramente os itens que estão há mais tempo sem receber acessos.
4. Arquitetura de Dados e Bancos de Dados
Replicação de Banco de Dados (Single-Leader / Master-Slave): Configuração em que todas as operações de escrita (INSERT, UPDATE, DELETE) ocorrem em um nó principal (Master), que envia o log de alterações para nós secundários (Slaves) dedicados exclusivamente a atender consultas de leitura (SELECT).
Replicação Multi-Master: Modelo em que múltiplos nós de banco de dados podem aceitar escritas simultaneamente, sincronizando alterações entre si em segundo plano e resolvendo conflitos de dados de forma assíncrona.
Sharding (Particionamento Horizontal): Técnica de dividir uma base de dados grande em frações menores e independentes (shards), distribuindo-as por múltiplos servidores por meio de uma chave de particionamento (sharding key).
Bancos de Dados NoSQL: Sistemas de armazenamento de dados agregados não relacionais (como chave-valor, documentos ou grafos) projetados para escalabilidade horizontal, esquemas flexíveis e eliminação de consultas com joins complexos no banco.
5. Processamento Assíncrono & Desacoplamento
Processamento Assíncrono: Desacoplamento entre a solicitação inicial de uma tarefa e sua execução real, permitindo que a aplicação responda imediatamente ao usuário enquanto o trabalho pesado ocorre em segundo plano.
Message Queues (Filas de Mensagens): Buffers de mensageria (como RabbitMQ, ActiveMQ ou estruturas em Redis) que armazenam tarefas enviadas pelos servidores web até que estes trabalhos sejam consumidos.
Background Workers: Grupo de servidores em segundo plano encarregados de monitorar a fila de mensagens, retirar trabalhos acumulados e executar o processamento computacional sem bloquear o frontend.
6. Sistemas Distribuição & Teoremas
Teorema CAP: Impossibilidade matemática que prova que um sistema distribuído sujeito a falhas inescapáveis de rede (Partition Tolerance) pode garantir apenas Consistência ou Disponibilidade em um par de escrita/leitura.
Consistência Forte (Linearizabilidade): Garantia de que qualquer operação de leitura retornará o resultado da escrita mais recente realizada no sistema, fazendo-o comportar-se como se operasse em um único nó central.
Consistência Eventual: Padrão que tolera atrasos temporários na replicação de dados entre os nós para manter a disponibilidade alta, garantindo que todas as réplicas eventualmente irão convergir para o mesmo estado após o reatamento da rede.
Consistent Hashing (Hash Consistente): Algoritmo que mapeia chaves e servidores em um anel de hash, permitindo adicionar ou remover nós com o mínimo de movimentação de dados e sem necessitar reordenar toda a base.
Algoritmos de Consenso (ex: Paxos, Raft): Protocolos distribuídos que permitem que um conjunto de nós independentes concorde de forma segura sobre uma sequência de eventos ou alterações de estado, mesmo diante da falha de minorias de nós.
Mantenha-se Atualizado
Cadastre-se na newsletter para receber artigos sobre o universo de produto toda semana diretamente no seu e-mail:
Conecte-se a temas de Tecnologia, Gestão de Projetos e Produtos Digitais
Receba ensaios práticos feitos sob medida para você, com uma leitura rápida e descomplicada.
🔒 Respeitamos sua privacidade. Seus dados estão seguros e você pode cancelar a qualquer momento (LGPD).
1. Scalability & Server Architecture
Vertical Scalability (Scale-Up): Consists of increasing system capacity by adding more resources (such as CPU, RAM, or disk storage) to a single server. It has physical, technological, and cost limits, in addition to creating a single point of failure.
Horizontal Scalability (Scale-Out): Consists of responding to increased demand by adding more servers (clones) in parallel to a resource pool or cluster.
Stateless Architecture: Architectural pattern where web servers do not store session data or user files on their local disks or memories. This allows any request to be handled identically by any server in the cluster.
Clones and Machine Images: Identical web servers created from a master template or image (such as an AMI). They allow quickly launching new instances and deploying updated code uniformly.
2. Traffic Management & Networking
Load Balancer: Hardware or software device positioned between clients and the server fleet to distribute traffic requests evenly.
Routing Algorithms (Round-Robin vs. Load-Based): Methods used by the load balancer to distribute traffic. Round-Robin sends requests in a simple sequential queue, while dynamic approaches periodically check the current load or processing of each server.
Sticky Sessions: Mechanism in which the load balancer stores a reference (usually via cookie) to ensure that subsequent requests from the same user are sent to the same server where their local session was initiated.
High Availability (High Availability / Failover): Capacity to keep the service active even in the face of hardware failures, using redundant nodes that operate in active-passive pairs with heartbeat signals to take over traffic if the primary machine fails.
3. Performance, Storage & Caching
In-Memory Caching: Ultra-high-speed buffer layer (such as Memcached or Redis) that stores frequently accessed data directly in RAM to avoid expensive queries to the physical database disk.
Latency: The total elapsed time to complete a single task or produce an individual result.
Throughput: The total amount of tasks, records, or requests that the system can process and complete per unit of time.
Cache Eviction Policies (e.g., LRU): Discard rules executed when the cache’s RAM reaches its limit. The Least Recently Used (LRU) algorithm removes items that have gone the longest without receiving access first.
4. Data Architecture & Databases
Database Replication (Single-Leader / Master-Slave): Configuration in which all write operations (INSERT, UPDATE, DELETE) occur on a primary node (Master), which sends the change log to secondary nodes (Slaves) dedicated exclusively to serving read queries (SELECT).
Multi-Master Replication: Model in which multiple database nodes can accept writes simultaneously, synchronizing changes with each other in the background and resolving data conflicts asynchronously.
Sharding (Horizontal Partitioning): Technique of dividing a large database into smaller, independent fractions (shards), distributing them across multiple servers using a partitioning key (sharding key).
NoSQL Databases: Non-relational aggregate data storage systems (such as key-value, document, or graph) designed for horizontal scalability, flexible schemas, and eliminating complex queries with joins in the database.
5. Asynchronous Processing & Decoupling
Asynchronous Processing: Decoupling between the initial request of a task and its actual execution, allowing the application to respond immediately to the user while heavy work occurs in the background.
Message Queues: Messaging buffers (such as RabbitMQ, ActiveMQ, or Redis structures) that store tasks sent by web servers until these jobs are consumed.
Background Workers: A group of background servers responsible for monitoring the message queue, picking up accumulated jobs, and executing computational processing without blocking the frontend.
6. Distributed Systems & Theorems
CAP Theorem: Mathematical impossibility proving that a distributed system subject to inescapable network partitions (Partition Tolerance) can guarantee only Consistency or Availability in a write/read pair.
Strong Consistency (Linearizability): Guarantee that any read operation will return the result of the most recent write performed on the system, making it behave as if operating on a single central node.
Eventual Consistency: Pattern that tolerates temporary delays in data replication between nodes to maintain high availability, guaranteeing that all replicas will eventually converge to the same state after network healing.
Consistent Hashing: Algorithm that maps keys and servers onto a hash ring, allowing nodes to be added or removed with minimal data movement and without needing to rehash the entire database.
Consensus Algorithms (e.g., Paxos, Raft): Distributed protocols that allow a set of independent nodes to safely agree on a sequence of events or state changes, even in the presence of minority node failures.
Stay Updated
Subscribe to the newsletter to receive actionable architecture and web security insights weekly directly in your inbox:
Conecte-se a temas de Tecnologia, Gestão de Projetos e Produtos Digitais
Receba ensaios práticos feitos sob medida para você, com uma leitura rápida e descomplicada.
🔒 Respeitamos sua privacidade. Seus dados estão seguros e você pode cancelar a qualquer momento (LGPD).
Reviews & Comments
Leave your 1 to 5 star rating and share your thoughts on this content.