System Design para iniciantes. Tudo o que você precisa saber System Design for beginners. Everything you need to know
A fundamental importância de planejar suas aplicações levando em consideração os conceitos de System Design e seus impactos reais no resultado final do produto. The fundamental importance of planning your applications while taking into account System Design concepts and their real-world impact on the final product.
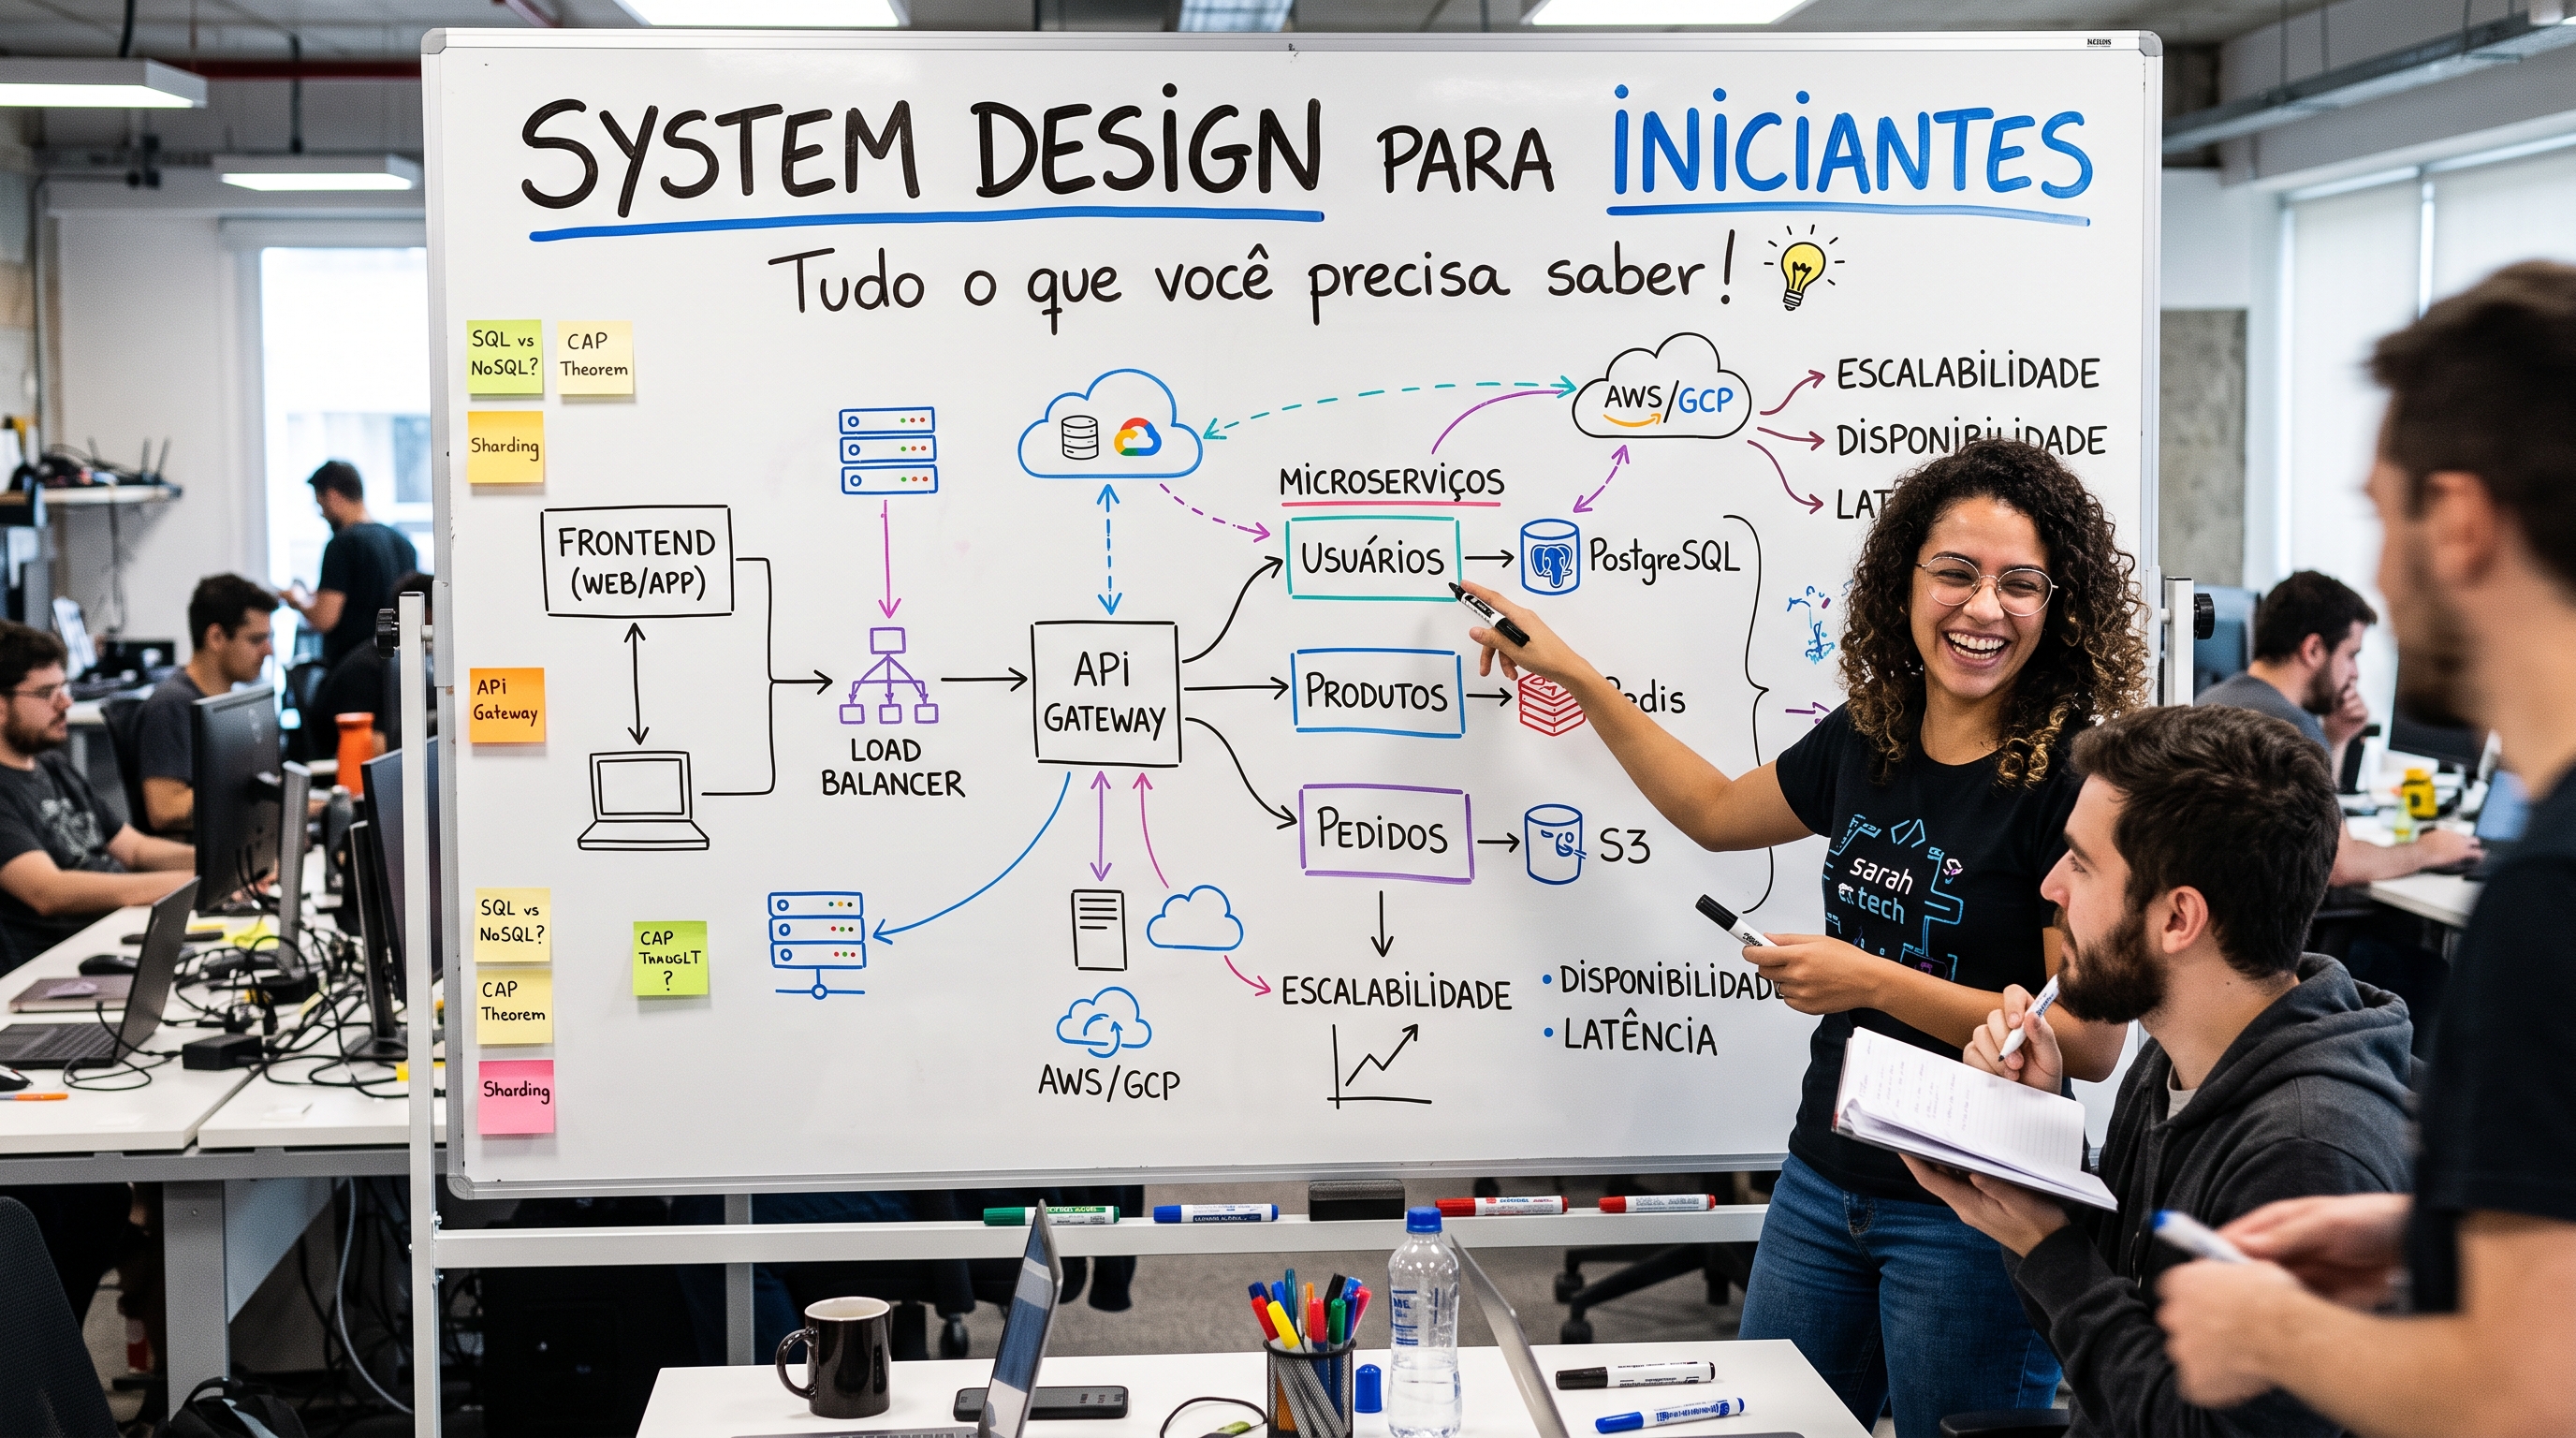
Imagine a seguinte situação. Você acabou de desenvolver um novo aplicativo incrível e o colocou no ar. No primeiro mês, algumas dezenas de amigos começam a usar o app e tudo funciona de forma impecável. Mas e se, da noite para o dia, o seu projeto for parar na página principal de um grande site de notícias ou viralizar nas redes sociais, atraindo centenas de milhares de acessos simultâneos? É exatamente nesse momento que a infraestrutura tradicional colapsa se não tiver sido planejada com antecedência.
O System Design (Design de Sistemas) é o campo da engenharia de software responsável por projetar a arquitetura de componentes (servidores, bancos de dados, redes e caches) para garantir que um sistema permaneça escalável, confiável e eficiente, mesmo diante de um crescimento massivo de carga e acessos.
Para iniciar no mundo do System Design, a primeira grande decisão arquitetural diz respeito a como escalar a sua infraestrutura. Existem dois caminhos clássicos:
- a escalabilidade vertical (scale-up)
- e a escalabilidade horizontal (scale-out)
A escalabilidade vertical consiste em adicionar mais recursos computacionais (por exemplo, mais memória RAM, CPUs mais potentes ou discos SSD mais rápidos) a um único servidor. Embora seja uma solução simples e direta no início, a escalabilidade vertical possui limites físicos incontornáveis, os servidores mais potentes do mercado são extremamente caros e, eventualmente, atinge-se o teto do que a tecnologia atual permite construir. Além disso, manter apenas uma máquina cria um perigoso ponto único de falha, termo conhecido como Single Point of Failure. Se esse servidor cair, todo o seu serviço fica indisponível. É por isso que sistemas de grande porte adotam a escalabilidade horizontal, que consiste em distribuir a carga de trabalho entre um agrupamento (cluster) de múltiplos servidores padronizados atuando em conjunto.
Quando você passa a operar com dezenas ou centenas de servidores web em paralelo, surge uma dúvida fundamental: como as requisições dos usuários na internet sabem para qual servidor específico devem ir? A resposta é o Load Balancer (Balanceador de Carga). Atuando como o “maestro” da sua rede, o balanceador de carga possui um endereço IP público que recebe todo o tráfego da internet e distribui os pacotes entre seus servidores web internos, que operam de forma segura em uma rede privada. A distribuição do tráfego pode seguir estratégias simples como o Round-Robin (onde cada nova requisição vai para o próximo servidor da fila de forma sequencial) ou algoritmos mais inteligentes baseados na carga de processamento atual de cada máquina. Para garantir que o próprio balanceador de carga não se torne um ponto único de falha, ambientes de produção implantam pares redundantes de balanceadores (em configurações ativo-passivo ou ativo-ativo) que monitoram a saúde um do outro por meio de sinais de heartbeat.
No entanto, adicionar múltiplos servidores web cria um grande desafio relacionado ao estado da aplicação. A regra de ouro da escalabilidade horizontal é manter a camada web totalmente stateless (sem estado). Se as sessões dos usuários ou arquivos temporários forem armazenados diretamente no disco local de um servidor específico, um usuário que fizer uma requisição no Servidor A e na ação seguinte for direcionado pelo balanceador para o Servidor B, ele será deslogado ou perderá seu carrinho de compras. Para solucionar esse problema e permitir o roteamento dinâmico sem fricção, a gestão de sessões e o armazenamento de arquivos devem ser terceirizados para camadas de dados centralizadas e compartilhadas, como repositórios NoSQL ou bancos de memória acessíveis por qualquer servidor do cluster.
Outro pilar essencial para alcançar alta performance sob tráfego intenso é o Caching (Armazenamento em Cache). Consultar dados persistidos em discos físicos ou SSDs é uma operação milhares de vezes mais lenta do que ler informações armazenadas diretamente na memória RAM. As camadas de cache em memória (utilizando tecnologias populares como Memcached ou Redis) funcionam como um buffer ultrarrápido entre a sua aplicação e o banco de dados. Em um padrão típico de leitura (read-through), a aplicação consulta primeiramente o cache. Se os dados estiverem presentes (cache hit), a resposta é entregue em milissegundos. Caso contrário (cache miss), o banco de dados é consultado e o resultado é gravado no cache para as próximas requisições. Essa estratégia reduz drasticamente a sobrecarga sobre o banco de dados e eleva a taxa de requisições por segundo que o sistema consegue suportar.
Mesmo com um cache eficiente, a camada de banco de dados eventualmente se tornará um gargalo à medida que o volume de escrita e leitura crescer. A maioria das aplicações web possui um perfil fortemente voltado para a leitura (read-heavy). Nesses cenários, a estratégia inicial de escalonamento do banco de dados é a Replicação Master-Slave (Líder-Seguidor). Todas as operações que alteram dados (writes, updates, deletes) são direcionadas ao banco Master, que replica essas alterações automaticamente para múltiplos bancos Slaves. Por sua vez, a aplicação distribui as milhares de consultas de leitura (reads) exclusivamente entre os Slaves.
Quando o volume total de dados ou a taxa de escrita supera a capacidade de um único servidor Master, adota-se o Sharding (ou Particionamento), técnica na qual o conjunto total de dados é fatiado em pedaços menores (shards) e distribuído entre diferentes máquinas por meio de uma chave de particionamento (sharding key). Para manter a interface do usuário rápida e responsiva, é preciso evitar que tarefas demoradas bloqueiem o ciclo de requisição e resposta do navegador, o que nos leva ao conceito de Processamento Assíncrono.
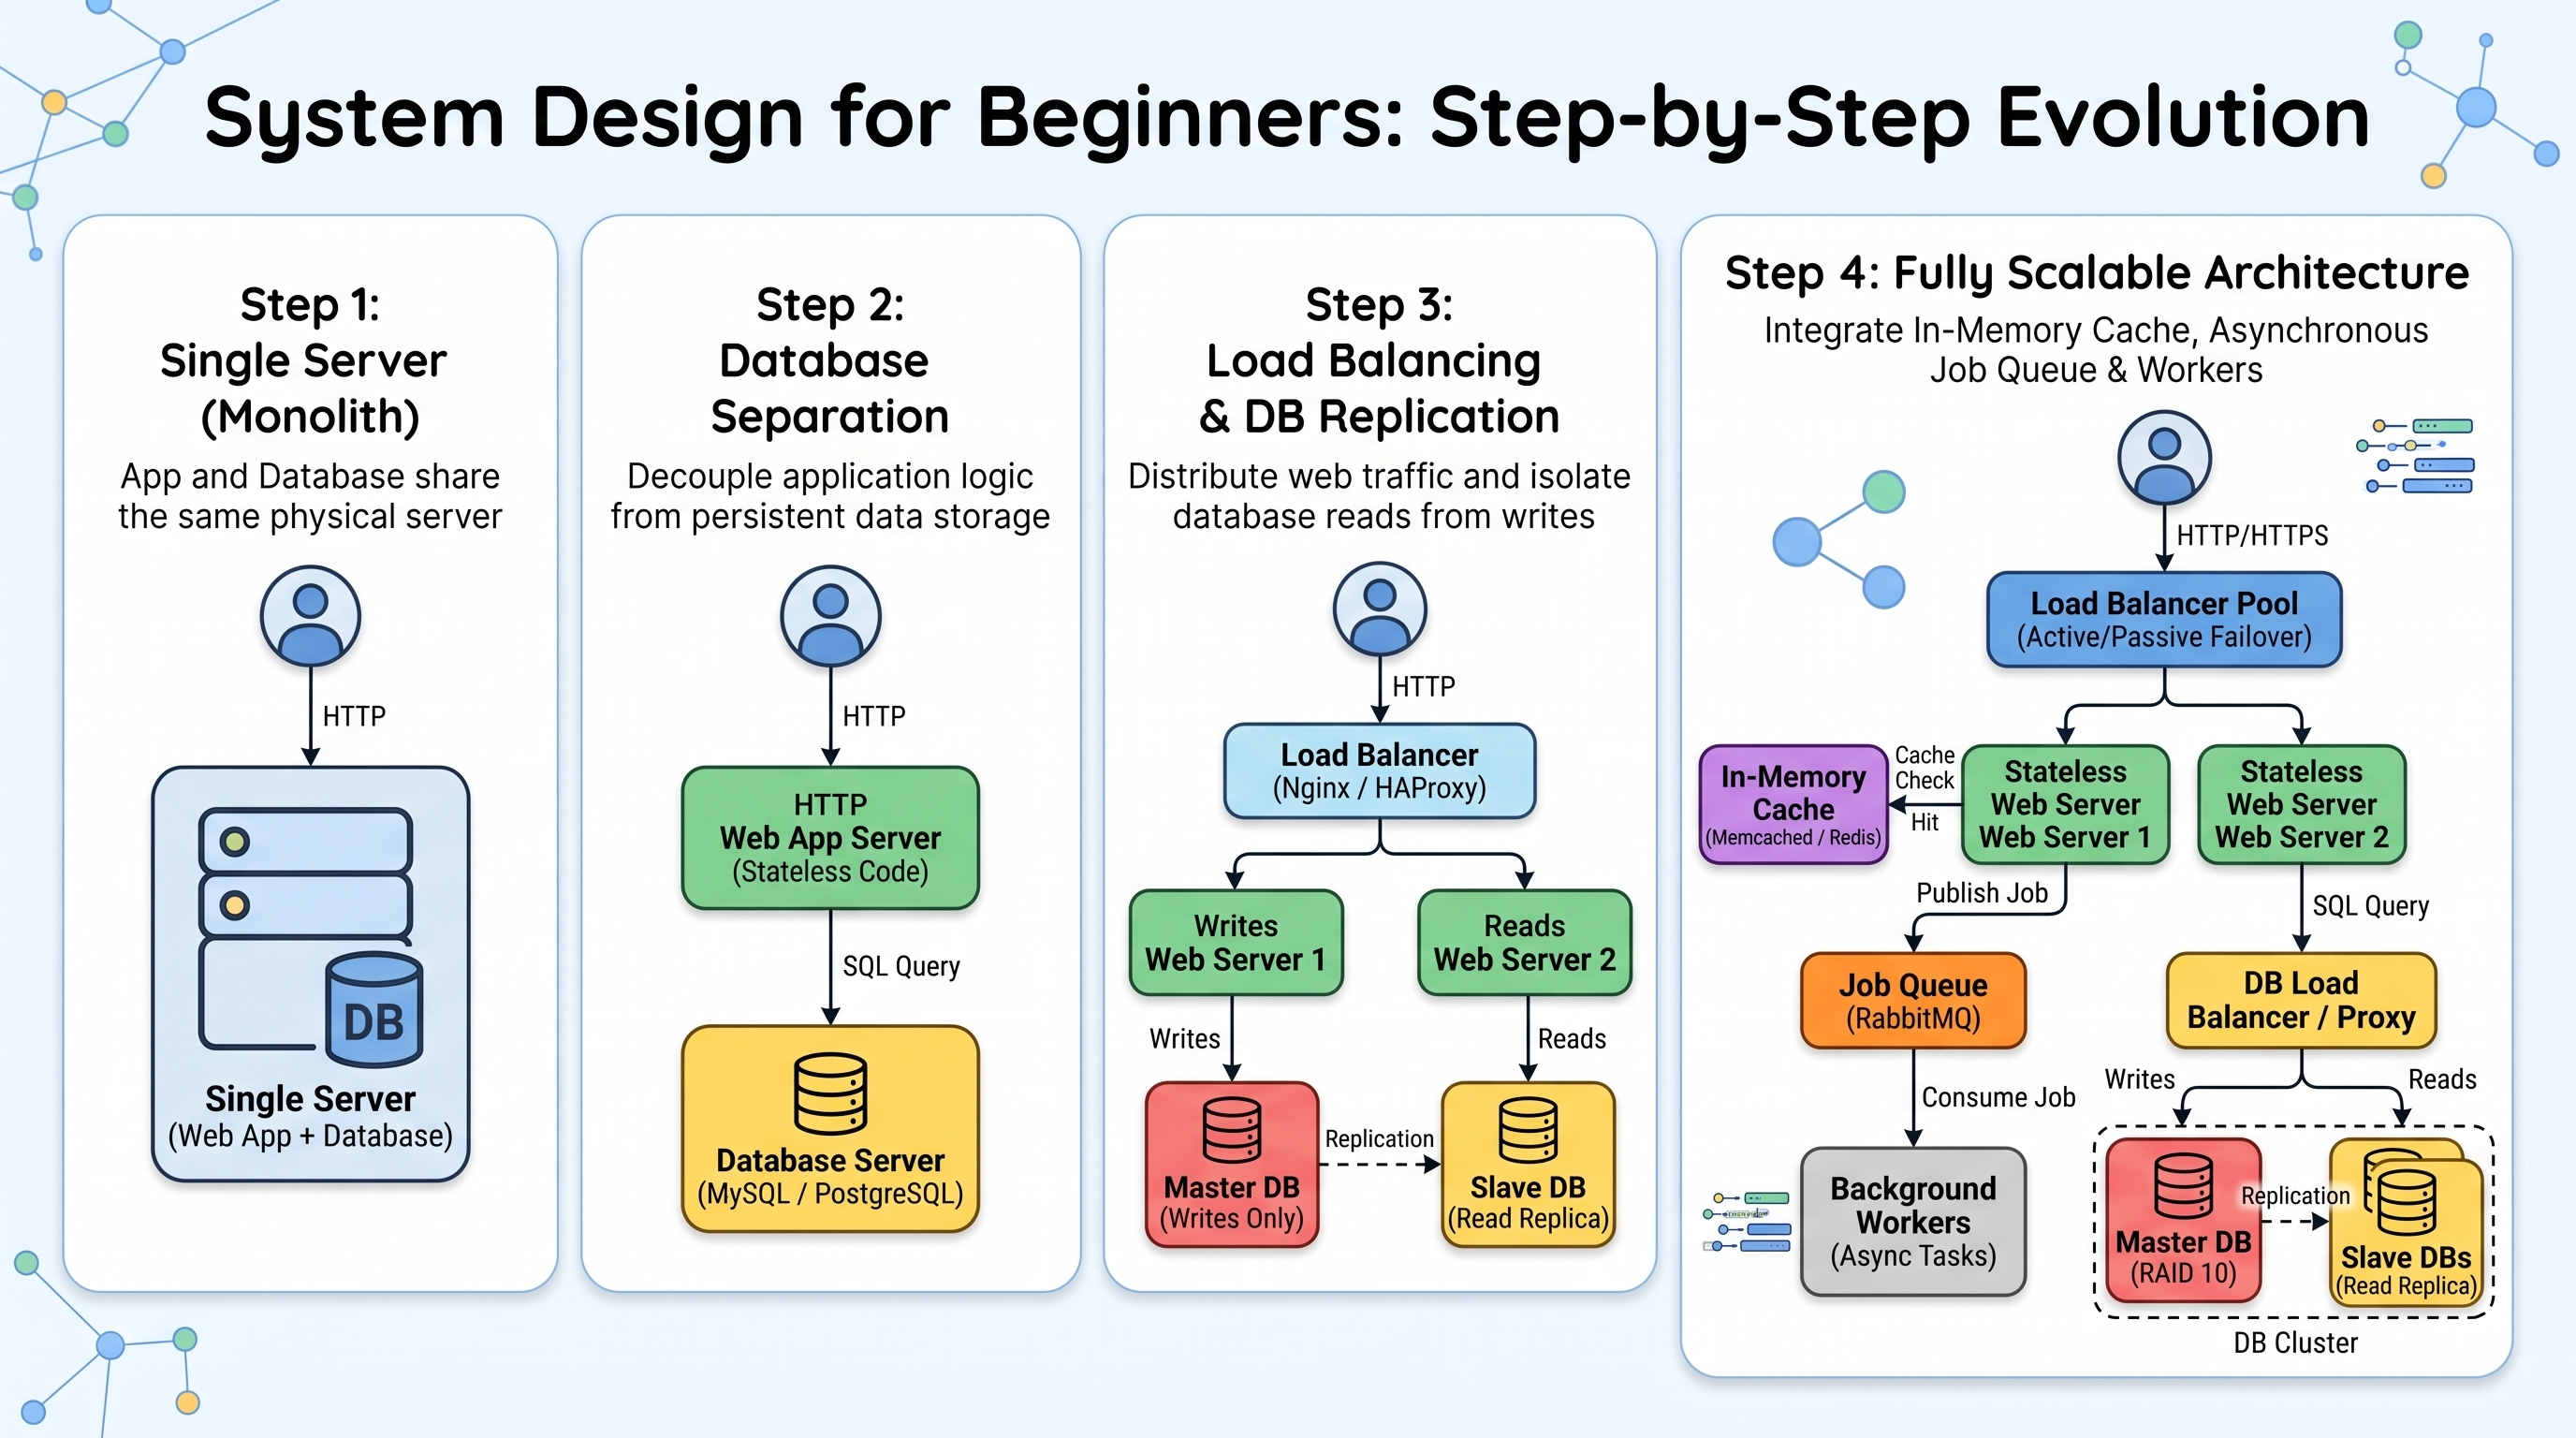
Operações computacionalmente pesadas, como o processamento de vídeos, geração de relatórios em PDF ou envio massivo de e-mails, não devem ser executadas em tempo real na camada web. Em vez disso, o servidor web publica a tarefa como uma mensagem em uma Fila de Mensagens (Job Queue, usando ferramentas como RabbitMQ ou ActiveMQ) e responde imediatamente ao usuário que a tarefa foi aceita. No plano de fundo, uma frota de servidores secundários (background workers) consome a fila e processa os trabalhos no seu próprio ritmo, desacoplando os componentes do sistema e permitindo um dimensionamento independente.
Dominar o System Design significa compreender que não existem soluções mágicas, apenas trade-offs (escolhas e compensações). O principal arcabouço teórico que ilustra isso é o Teorema CAP, que estabelece que um sistema distribuído sujeito a falhas inescapáveis de rede (Partition Tolerance) deve escolher entre Consistência (todos os nós veem os mesmos dados exatamente ao mesmo tempo) ou Disponibilidade (toda requisição recebe uma resposta sem erros, mesmo que os dados estejam temporariamente desatualizados). Da mesma forma, os arquitetos devem balancear a Latência (o tempo necessário para concluir uma única tarefa) e o Throughput (a quantidade total de tarefas que o sistema executa por unidade de tempo). Compreender essas restrições permite projetar sistemas sob medida para as necessidades reais do negócio.
Em resumo, projetar sistemas escaláveis não é um evento único, mas sim um processo iterativo e contínuo. Você não precisa implantar um cluster com dezenas de componentes no primeiro dia. O segredo está em entender os blocos fundamentais de construção, balanceadores, caches, replicação e filas, para saber exatamente qual alavanca puxar à medida que sua base de usuários crescer. Comece simples, meça o desempenho da sua aplicação, identifique os gargalos reais e evolua sua arquitetura passo a passo com confiança.
Mantenha-se Atualizado
Cadastre-se na newsletter para receber artigos sobre o universo de produto toda semana diretamente no seu e-mail:
Conecte-se a temas de Tecnologia, Gestão de Projetos e Produtos Digitais
Receba ensaios práticos feitos sob medida para você, com uma leitura rápida e descomplicada.
🔒 Respeitamos sua privacidade. Seus dados estão seguros e você pode cancelar a qualquer momento (LGPD).
Imagine the following scenario. You have just built an incredible new app and launched it online. In the first month, a few dozen friends start using the app, and everything works impeccably. But what if, overnight, your project ends up on the homepage of a major news site or goes viral on social media, attracting hundreds of thousands of simultaneous visits? That is exactly when traditional infrastructure collapses if it hasn’t been planned in advance.
System Design is the field of software engineering responsible for designing component architecture (servers, databases, networks, and caches) to ensure that a system remains scalable, reliable, and efficient, even when facing massive growth in load and traffic.
To get started in the world of System Design, the first major architectural decision concerns how to scale your infrastructure. There are two classic approaches:
- Vertical Scaling (scale-up)
- Horizontal Scaling (scale-out)
Vertical scaling consists of adding more computational resources (for example, more RAM, more powerful CPUs, or faster SSD drives) to a single server. While it is a simple and straightforward solution initially, vertical scaling has unavoidable physical limits. The most powerful servers on the market are extremely expensive, and eventually, you reach the ceiling of what current technology allows. Furthermore, maintaining only one machine creates a dangerous single point of failure (SPOF). If that server goes down, your entire service becomes unavailable. That is why large-scale systems adopt horizontal scaling, which consists of distributing the workload across a cluster of multiple standardized servers acting together.
When you start operating with dozens or hundreds of web servers in parallel, a fundamental question arises. How do user requests from the internet know which specific server to go to? The answer is the Load Balancer. Acting as the “conductor” of your network, the load balancer has a public IP address that receives all internet traffic and distributes packets among internal web servers operating securely within a private network. Traffic distribution can follow simple strategies like Round-Robin (where each new request goes to the next server in line sequentially) or more intelligent algorithms based on the current processing load of each machine. To ensure the load balancer itself does not become a single point of failure, production environments deploy redundant pairs of load balancers (in active-passive or active-active configurations) that monitor each other’s health via heartbeat signals.
However, adding multiple web servers creates a major challenge regarding application state. The golden rule of horizontal scaling is to keep the web layer completely stateless. If user sessions or temporary files are stored directly on the local disk of a specific server, a user who makes a request to Server A and is subsequently directed by the load balancer to Server B will be logged out or lose their shopping cart. To solve this problem and enable seamless dynamic routing, session management and file storage must be outsourced to centralized, shared data layers, such as NoSQL repositories or in-memory databases accessible by any server in the cluster.
Another essential pillar for achieving high performance under heavy traffic is Caching. Querying data persisted on physical disks or SSDs is an operation thousands of times slower than reading information stored directly in RAM. In-memory caching layers (using popular technologies like Memcached or Redis) act as an ultra-fast buffer between your application and the database. In a typical read pattern (read-through), the application queries the cache first. If the data is present (cache hit), the response is delivered in milliseconds. Otherwise (cache miss), the database is queried, and the result is written to the cache for subsequent requests. This strategy dramatically reduces database overhead and increases the number of requests per second the system can handle.
Even with an efficient cache, the database layer will eventually become a bottleneck as read and write volume grows. Most web applications have a strongly read-heavy profile. In these scenarios, the primary database scaling strategy is Master-Slave (Leader-Follower) Replication. All data-modifying operations (writes, updates, deletes) are directed to the Master database, which automatically replicates these changes to multiple Slave databases. In turn, the application distributes thousands of read queries exclusively among the Slaves.
When total data volume or write rate exceeds the capacity of a single Master server, Sharding (or Partitioning) is adopted as a technique in which the complete dataset is divided into smaller pieces (shards) and distributed across different machines using a sharding key. To keep the user interface fast and responsive, time-consuming tasks must be prevented from blocking the browser’s request-response cycle, leading to the concept of Asynchronous Processing.
Computationally heavy operations, such as video processing, PDF report generation, or bulk email sending, should not be executed in real time on the web layer. Instead, the web server publishes the task as a message to a Job Queue (using tools like RabbitMQ or ActiveMQ) and immediately responds to the user that the task was accepted. In the background, a fleet of secondary servers (background workers) consumes the queue and processes the jobs at their own pace, decoupling system components and allowing independent scaling.
Mastering System Design means understanding that there are no magic solutions, only trade-offs. The main theoretical framework illustrating this is the CAP Theorem, which states that a distributed system subject to unavoidable network partitions (Partition Tolerance) must choose between Consistency (all nodes see the same data at the same time) or Availability (every request receives a non-error response, even if data is temporarily outdated). Similarly, architects must balance Latency (the time required to complete a single task) and Throughput (the total amount of tasks the system performs per unit of time). Understanding these constraints allows for designing systems tailored to actual business needs.
In summary, designing scalable systems is not a single event, but an iterative and continuous process. You don’t need to deploy a cluster with dozens of components on day one. The secret lies in understanding the fundamental building blocks (load balancers, caches, replication, and queues) so you know exactly which lever to pull as your user base grows. Start simple, measure your application’s performance, identify real bottlenecks, and evolve your architecture step by step with confidence.
Stay Updated
Subscribe to the newsletter to receive actionable architecture and web security insights weekly directly in your inbox:
Conecte-se a temas de Tecnologia, Gestão de Projetos e Produtos Digitais
Receba ensaios práticos feitos sob medida para você, com uma leitura rápida e descomplicada.
🔒 Respeitamos sua privacidade. Seus dados estão seguros e você pode cancelar a qualquer momento (LGPD).
Reviews & Comments
Leave your 1 to 5 star rating and share your thoughts on this content.